Как честно сравнить системы памяти для AI-агентов
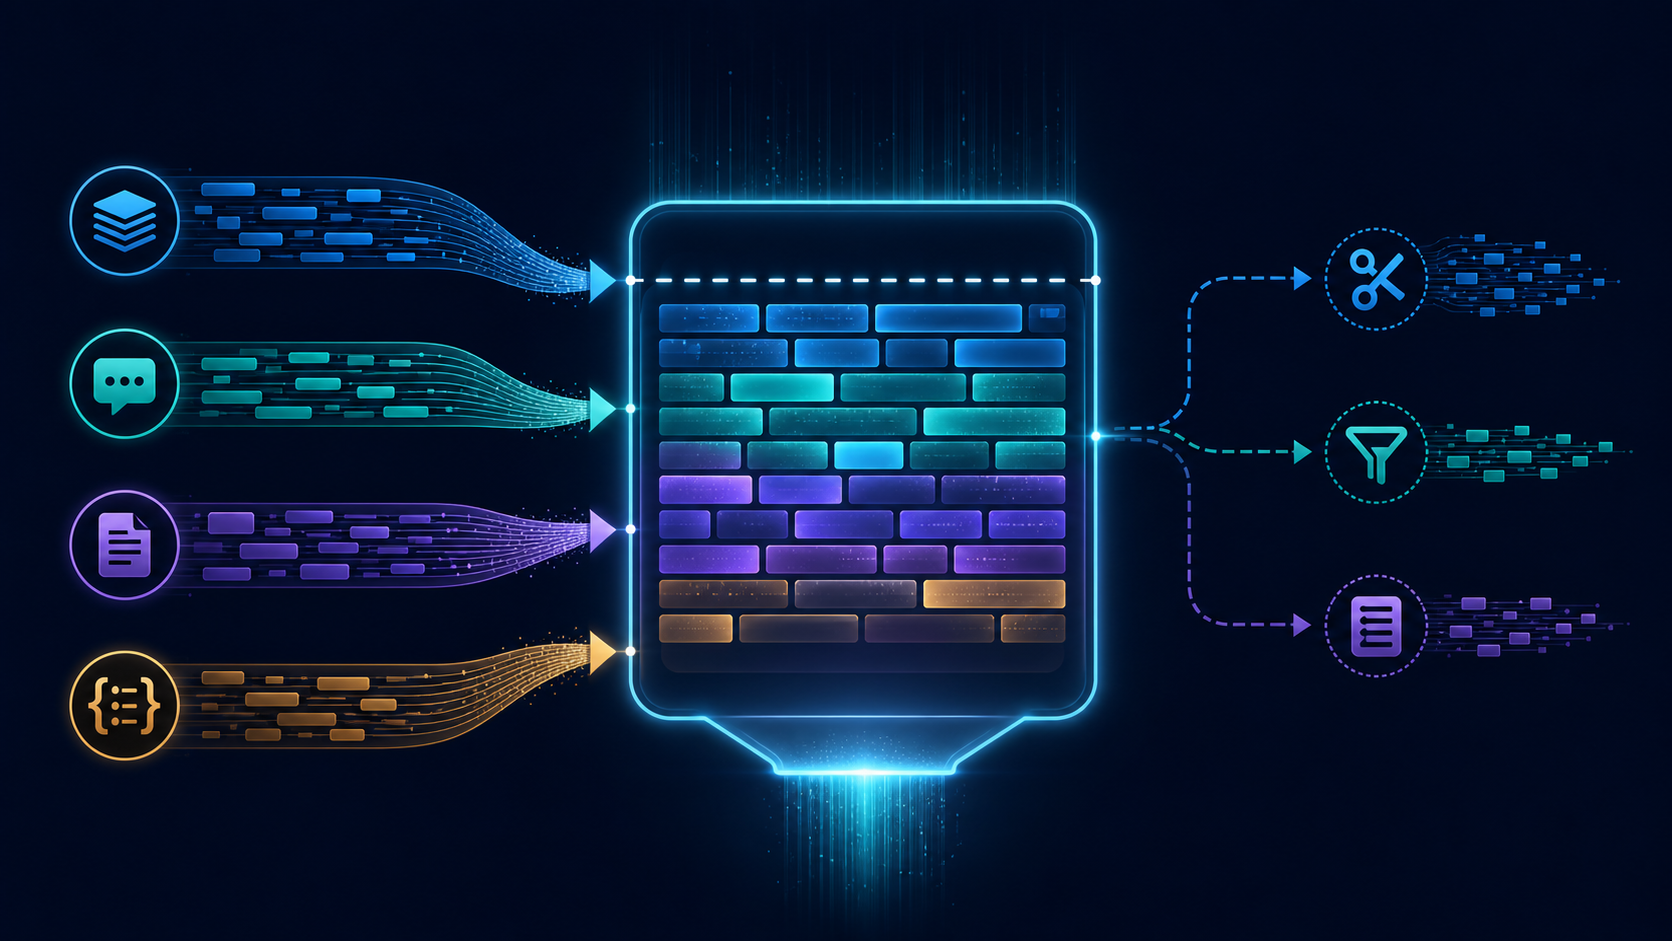
Почти любое сравнение памяти агентов, которое попадается в обзорах, на самом деле сравнивает сразу три вещи: саму память, модель, которая пишет ответ, и способ, которым этот ответ оценивают. Если у системы A ответы пишет одна модель со своим промптом, а у системы B другая, разница в итоговом балле ничего не говорит о памяти. Ниже собран воспроизводимый стенд. Все системы подключаются к нему через один интерфейс add/search, а всё, что идёт после поиска, у них общее.
Что именно мы измеряем
Под системой памяти здесь понимается компонент, который принимает реплики диалога и по запросу возвращает релевантный контекст. Точное определение и соседние термины есть в статье память агента в глоссарии. Честный тест держит переменной только одну часть конвейера:
- Запись: система получает одни и те же сообщения в одном и том же порядке.
- Поиск: система получает один и тот же вопрос и возвращает не больше K фрагментов или токенов.
- Ответ: одна фиксированная модель, один шаблон промпта, температура 0.
- Оценка: одна процедура для всех систем, судья с зафиксированной версией и промптом, плюс детерминированные метрики.
Меняется только реализация шагов 1 и 2. Если на шагах 3 и 4 у систем что-то различается, сравнение уже нечестное.
Откуда берутся искажения
- Разные модели ответов. Сильная модель вытащит ответ даже из шумного контекста, слабая не справится и с хорошим. Получится, что вы сравнили модели, а не память.
- Свой промпт у каждой системы. Многие библиотеки памяти поставляются со встроенным шаблоном «ответь, используя воспоминания». Его надо отключить и подставить общий.
- Разный бюджет контекста. Система, которая вернула 8000 токенов, почти всегда обгонит систему с 500 токенами. Бюджет фиксируется и записывается в отчёт.
- Разные судьи и метрики. Exact match, F1 и LLM-судья дают несопоставимые числа. Ещё хуже, когда у судьи разные промпты.
- Утечка вопросов. Если система увидела вопросы на этапе записи (например, через общий кэш), результат завышен.
- Недетерминизм. Один прогон с ненулевой температурой не годится как доказательство.
Шаг 1. Структура стенда
Дальше идёт пример структуры проекта. Названия файлов условные, адаптируйте их под свой репозиторий.
memory-bench/
  data/
    dialogs.jsonl        # сессии диалогов
    questions.jsonl      # вопросы с эталонными ответами
  adapters/
    base.py              # интерфейс MemorySystem
    full_context.py      # базовая линия: весь диалог
    no_memory.py         # нижняя граница: пустой контекст
    my_vector_store.py   # ваша система
  harness.py             # прогон: add → search → answer
  evaluate.py            # общая оценка
  config.yaml            # зафиксированные параметры
Формат данных в примере такой:
// dialogs.jsonl — одна строка = одно сообщение
{"conv_id": "c01", "session": 1, "turn": 3, "role": "user",
 "text": "Я переехал в Казань в марте", "ts": "2026-03-14T10:00:00Z"}

// questions.jsonl
{"conv_id": "c01", "qid": "c01-q4", "question": "В каком городе живёт пользователь?",
 "answer": "Казань", "type": "single_hop"}
Поле type понадобится для разбивки результатов: одношаговые вопросы, многошаговые, временные, вопросы на обновление факта, вопросы без ответа. Если в отчёте только общий балл, он почти наверняка скрывает, где именно система ошибается.
Шаг 2. Единый интерфейс Add/Search
# adapters/base.py
from abc import ABC, abstractmethod
from dataclasses import dataclass

@dataclass
class Message:
    conv_id: str
    role: str
    text: str
    ts: str

@dataclass
class Hit:
    text: str
    score: float | None = None

class MemorySystem(ABC):
    name: str

    @abstractmethod
    def reset(self, conv_id: str) -> None:
        """Полностью очистить память для conv_id."""

    @abstractmethod
    def add(self, msg: Message) -> None:
        """Записать одно сообщение. Вопросы сюда не попадают."""

    @abstractmethod
    def search(self, conv_id: str, query: str, k: int) -> list[Hit]:
        """Вернуть не более k фрагментов. Без генерации ответа."""
Главное правило: search возвращает только извлечённый контекст. Если библиотека умеет лишь «ответить на вопрос», для честного теста её нужно обернуть так, чтобы отдавались сырые воспоминания. Если это невозможно, отметьте в отчёте, что для этой системы шаг ответа не изолирован.
Две обязательные базовые линии:
# adapters/full_context.py — верхний ориентир
class FullContext(MemorySystem):
    name = "full_context"
    def __init__(self): self.store = {}
    def reset(self, conv_id): self.store[conv_id] = []
    def add(self, msg): self.store[msg.conv_id].append(f"[{msg.ts}] {msg.role}: {msg.text}")
    def search(self, conv_id, query, k):
        return [Hit(text="\n".join(self.store[conv_id]))]

# adapters/no_memory.py — нижняя граница
class NoMemory(MemorySystem):
    name = "no_memory"
    def reset(self, conv_id): pass
    def add(self, msg): pass
    def search(self, conv_id, query, k): return []
Если ваша система не обгоняет no_memory заметно, проблема в данных или в стенде. Если она обгоняет full_context на коротких диалогах, проверьте, нет ли утечки.
Шаг 3. Общий harness
# harness.py (сокращённо)
import json, hashlib, yaml
from tiktoken import get_encoding  # или токенизатор вашей модели

cfg = yaml.safe_load(open("config.yaml"))
enc = get_encoding(cfg["tokenizer"])

ANSWER_PROMPT = open("prompts/answer.txt").read()   # один для всех

def truncate(hits, budget):
    out, used = [], 0
    for h in hits:
        n = len(enc.encode(h.text))
        if used + n > budget:
            break
        out.append(h.text); used += n
    return "\n---\n".join(out), used

def run(system, dialogs, questions, llm):
    rows = []
    for conv_id, msgs in dialogs.items():
        system.reset(conv_id)
        for m in msgs:                       # одинаковый порядок
            system.add(m)
        for q in questions[conv_id]:
            hits = system.search(conv_id, q["question"], cfg["k"])
            ctx, used = truncate(hits, cfg["context_budget_tokens"])
            prompt = ANSWER_PROMPT.format(context=ctx, question=q["question"])
            ans = llm(prompt, model=cfg["answer_model"], temperature=0, seed=cfg["seed"])
            rows.append({"system": system.name, "qid": q["qid"], "type": q["type"],
                         "context_tokens": used, "prediction": ans,
                         "gold": q["answer"],
                         "prompt_sha": hashlib.sha256(ANSWER_PROMPT.encode()).hexdigest()[:12]})
    return rows
Функцию llm реализуйте один раз через клиент вашего провайдера и отдавайте её всем системам. Обрезка по бюджету делается снаружи адаптера, поэтому лишний контекст не даст системе преимущества.
Пример config.yaml. Значения нужно подставить свои, это не рекомендация:
answer_model: "<зафиксированная версия модели ответов>"
judge_model:  "<зафиксированная версия модели-судьи>"
tokenizer: "cl100k_base"
k: 10
context_budget_tokens: 2000
seed: 42
runs: 3
Шаг 4. Общая процедура оценки
Используйте сразу два слоя оценки:
- Детерминированные метрики: нормализованный exact match и токенный F1. Они дешёвые и воспроизводимые, но плохо справляются с перефразированием.
- LLM-судья: бинарный вердикт «ответ эквивалентен эталону», с зафиксированными моделью, промптом и температурой 0. Судья не должен знать, какая система дала ответ.
# evaluate.py (фрагмент)
import random
JUDGE_PROMPT = open("prompts/judge.txt").read()

def judge_all(rows, llm, cfg):
    random.Random(cfg["seed"]).shuffle(rows)      # перемешиваем системы
    for r in rows:
        p = JUDGE_PROMPT.format(question=r["qid"], gold=r["gold"], pred=r["prediction"])
        r["judge"] = llm(p, model=cfg["judge_model"], temperature=0).strip().upper() == "YES"
    return rows
Для вопросов без ответа правильным считается явный отказ («в памяти нет данных»). Эти вопросы считайте отдельно: так видно, какие системы склонны галлюцинировать по нерелевантному контексту.
Шаг 5. Запуск
Команды безопасны: они пишут только в локальную папку results/. Ключи API передаются через переменные окружения, в репозиторий их не кладите.
python -m venv .venv && . .venv/bin/activate
pip install -r requirements.txt
export LLM_API_KEY=...            # не коммитить

python harness.py --systems no_memory,full_context,my_vector_store \
                  --runs 3 --out results/run.jsonl
python evaluate.py --in results/run.jsonl --out results/report.csv
git rev-parse HEAD > results/commit.txt
Проверка результата
Прежде чем публиковать цифры, пройдите по списку:
- У всех строк в
run.jsonlодинаковыйprompt_shaи одна и та жеanswer_model. context_tokensни у одной строки не больше бюджета. Посмотрите и среднее по системам: если одна стабильно использует половину бюджета, это тоже надо указать.- Порядок систем:
no_memory< ваша система ≤ примерноfull_context(на диалогах, которые помещаются в бюджет). Если порядок другой, ищите баг. - Расхождение между прогонами меньше разницы между системами. Сообщайте среднее и разброс по
runs, а не лучший прогон. - Вручную проверьте 30–50 случайных вердиктов судьи. Если судья заметно расходится с вами, поправьте его промпт и перезапустите оценку для всех систем.
- Таблица результатов разбита по
typeвопросов и содержит задержкуadd/search, если она для вас важна.
Типовые ошибки
- Встроенный ответчик библиотеки. Систему «похвалили», но на самом деле сработала её внутренняя модель и её промпт.
- Бюджет в фрагментах вместо токенов. 10 фрагментов по 50 токенов и 10 фрагментов по 800 токенов нельзя сравнивать.
- Общее состояние между диалогами. Не вызвали
reset, и в результатах появились «воспоминания» из соседнего разговора. - Асинхронная запись. Некоторые системы индексируют в фоне. Перед первым
searchдождитесь окончания индексации, иначе ответы будут случайно хуже. - Подгонка под тест. Параметры (k, размер чанка) крутили на тех же вопросах, на которых потом отчитались. Нужен отдельный dev-набор.
- Сравнение с чужими цифрами. Число из чужого отчёта получено на другом стенде. Сравнивайте только системы, прогнанные через ваш harness.
Ограничения подхода
- Интерфейс
add/searchне подходит для систем, где память и рассуждение неразделимы (например, агент сам решает, что записать, через tool calls). Для них нужен отдельный сценарий, где фиксируется модель агента. - Одна фиксированная модель ответов даёт честное сравнение, но выводы относятся к этой модели. Если важна переносимость, повторите тест со второй моделью.
- LLM-судья сам по себе источник систематической ошибки. Он сравним между системами, но абсолютные значения точности условны.
- Синтетические диалоги проще реальных. Хороший результат на них ещё не означает хорошего поведения в продакшене.
- Стоимость и задержка зависят от инфраструктуры, поэтому их лучше указывать как собственные измерения с описанием окружения, а не как свойство системы.
Итог
Как честно сравнить системы памяти для AI-агентов: поставить их в одинаковые условия везде, кроме самой памяти. Одинаковые данные и порядок записи, одинаковый бюджет контекста, одна модель ответов с одним промптом, один слепой судья, несколько прогонов и две базовые линии. Всё остальное, что попадает в «сравнение», скорее мешает, чем помогает.
Похожие практические разборы собраны в гайдах, а термины из статьи объяснены в глоссарии.